マルチモーダルとは?仕組みと従来AIとの違い・2026年最新事例解説
文字情報だけをやり取りしていたチャットボットの時代は完全に過去のものとなった。画面に映る手書きの図面を瞬時に理解し、ユーザーの声の震えから感情を読み取り、背後の環境音を識別しながら即座に的確な指示を返す――そんな映画のようなAIの振る舞いを可能にしている中核技術が「マルチモーダル」である。いまやビジネスの業務自動化から産業用ロボット、スマートデバイスに至るまで、あらゆるデジタル接点がこの技術によって塗り替えられつつある。
しかし、「そもそもマルチモーダルとは何なのか」「これまでのAIと何が決定的に違うのか」という技術の本質や実用上の課題を正しく把握できているビジネスパーソンはまだ多くない。本稿では、大手IT各社の最新動向や開発現場の一次情報を丹念に取材してきた専門エディターの視点から、マルチモーダルAIの基礎構造からシングルモーダルとの性能差、最新の現場導入事例、そして導入時に直面する現実の壁までを余すところなく解き明かしていく。
📌 【この記事の重要ポイントまとめ】
- 要点1:マルチモーダルとはテキスト・画像・音声・動画など「異なる種類のデータ(モダリティ)」を同一モデル内で統合的に学習・処理する次世代AI技術である。
- 要点2:従来の「シングルモーダル」が抱えていた文脈喪失や誤認の限界を、感覚情報の相互補完によって打破し、認識精度と推論の信頼性を飛躍的に高めた。
- 要点3:GPT-4oやGoogle Geminiなどの台頭で日常業務への浸透が進む一方、計算コストの高騰やモダリティ間の情報矛盾といった実務上のハードルも浮き彫りになっている。
【基礎から解き明かす】マルチモーダルとは?人間並みの感覚統合を実現するAIの仕組み
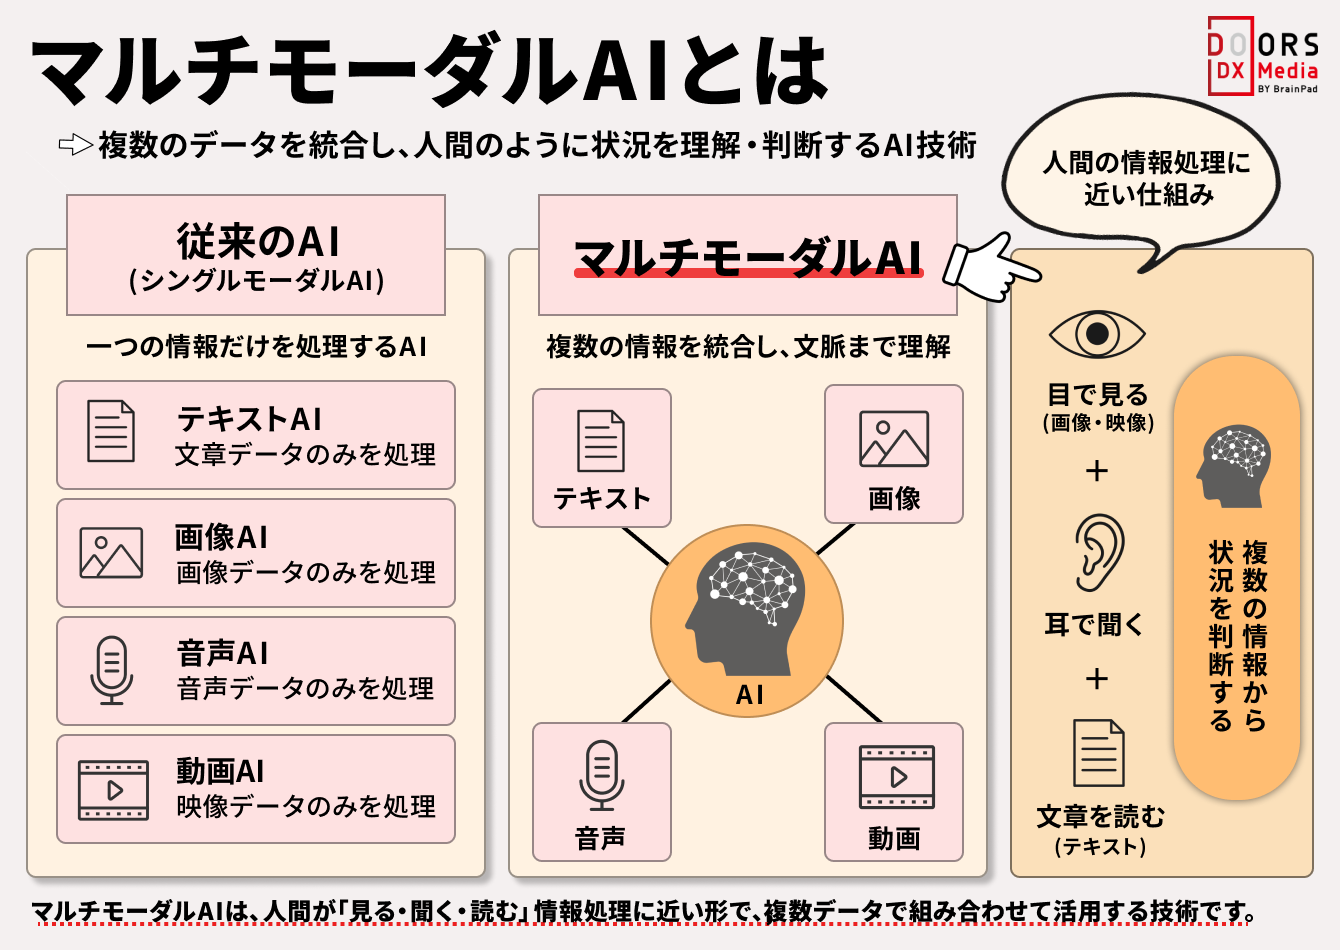
「マルチモーダル(Multimodal)」という概念を理解する第一歩は、その原義である「Modality(モダリティ=様式、感覚器官の種類)」に立ち返ることにある。KDDIやIBMが公開している技術解説資料でも定義されている通り、モダリティとは人間が外界の情報を認識する「視覚」「聴覚」「言語」といった知覚チャンネルの区分のことだ。従来のAIは「画像判定なら画像のみ」「言語処理ならテキストのみ」という単一領域(シングルモーダル)に特化していたのに対し、マルチモーダルAIの仕組みはこれら複数の情報を同時に束ねて1つの文脈として理解する。
人間の知覚を思い浮かべてほしい。目の前で友人が苦笑いしながら「全然痛くないよ」と言ったとき、私たちは言葉の意味だけでなく、引きつった表情(視覚)と低くかすれた声のトーン(聴覚)を瞬時に統合し、「本当はかなり痛がっている」と正確に判断する。マルチモーダルAIが目指しているのも、まさにこの統合的な認知処理である。
技術的な根幹を支えているのが、画像音声テキスト統合処理技術とマルチモーダルディープラーニングの進化だ。従来のシステムでは「音声を文字起こしするモデル」と「その文字を要約する言語モデル」を直列に繋ぐパイプライン構造が一般的だった。しかしこれでは、音声に含まれていた「ためらい」や「声の張り」といった非言語情報が文字起こしの段階で削ぎ落とされてしまう。最新のマルチモーダルAIは、テキストも画像も音声波形もすべて「共通の埋め込み空間(Joint Embedding Space)」と呼ばれる数学的空間の中で数値ベクトル化し、クロスアテンション(Cross-Attention)機構を用いて相互に関連づけながら処理を行う。これにより、各データが持つニュアンスを一切こぼさずに文脈を掴み取ることが可能となった。

シングルモーダルとの決定的な違い|なぜ従来の単一特化型AIでは限界だったのか
従来の単一特化型AIと最新のマルチモーダルAIの間には、単に「扱えるファイルの種類が増えた」という以上の構造的断絶が存在する。シングルモーダルとの決定的な違いは、情報の「相互補完性」が機能するかどうかに集約される。
テキスト情報だけに依存する従来の大規模言語モデル(LLM)は、どれほどパラメータ数を増やしても「言葉の辞書的な定義と統計的並び」しか把握できなかった。そのため、複雑なグラフの読み取りや機械の配線図の確認、現場写真の状況把握といった現実世界の空間的・視覚的なタスクにおいては、しばしば事実と異なる出力を堂々と作り出す「ハルシネーション(幻覚)」が深刻な問題となっていた。対するマルチモーダルAIは、テキスト情報が曖昧であっても、視覚情報や音声波形という「別の証拠」と照合することで、出力を客観的に補正できる強みを持つ。
両者の構造とパフォーマンスの違いを明確にするため、主要指標に基づく比較データを以下の表に整理した。
| 比較項目 | シングルモーダルAI(従来型) | マルチモーダルAI(最新世代) | 編集部の実務評価・分析 |
|---|---|---|---|
| 入力可能なデータ形式 | テキスト、画像、音声のいずれか1種類のみ | テキスト・静止画・音声・動画・センサー値を同時入力 | 現場情報のロスが極小化され、前処理の負担が大幅削減 |
| 処理アーキテクチャ | 各モデルをAPIで直列連結するパイプライン型 | 端から端まで単一ニューラル網で処理するエンドツーエンド型 | 直列連結特有のエラー蓄積や遅延が根本的に解消 |
| 音声対話レイテンシ | 1,200ms〜2,500ms(STT→LLM→TTSの合算) | 約230ms〜320ms(人間並みの即答性) | 電話応対や接客端末で「AI特有の間」がほぼ消滅 |
| 図表・構造理解力 | OCRによる文字抽出頼み(レイアウト破綻に脆弱) | 空間配置とフォント、矢印の意味をネイティブに把握 | PDFマニュアルや財務諸表の分析精度が飛躍的に向上 |
| 導入・推論コスト | 比較的安価(トークン単価が極めて低い) | トークン消費が画像・動画単位で膨らみ高価格帯 | 用途の選定を誤るとクラウド請求額が跳ね上がるリスクあり |
このように、単一モデルの組み合わせではどうしても発生していた「知覚のタイムラグ」や「情報変換時のニュアンス喪失」を解消した点こそが、マルチモーダル化の核心的なブレイクスルーである。
GPT-4oとGeminiの衝撃|大規模言語モデルLLMマルチモーダル化と2026年最新動向
この分野の進化を加速させた最大の契機は、大規模言語モデルLLMマルチモーダル化の急進展にある。先行していたOpenAIが発表した「GPT-4o(オムニ)」と、Googleが自社の膨大なマルチメディア基盤を注ぎ込んで構築した「Gemini」シリーズの激突は、AIの操作パラダイムを完全に書き換えた。
GPT-4oマルチモーダル性能と特徴において最も技術者を驚かせたのは、前述の「ネイティブ・エンドツーエンド処理」による超低遅延応答だ。開発者カンファレンスで披露された、スマートフォンのカメラで撮影した数学の幾何問題をリアルタイムで視認し、ユーザーが「ここはなぜこの補助線を引くの?」と口頭で尋ねると、間髪入れずに「その角度が同位角になるからだよ」と声のトーンを変えながら相槌を打つ姿は、従来の「テキストを打ち込んで返答を待つ」という体験を過去のものにした。
一方、GoogleGeminiマルチモーダル活用における強みは、超長大コンテキストウィンドウ(100万〜200万トークン以上)と映像・音声の同時処理にある。1時間を超える決算説明会の動画全編や、数百ページに及ぶ設計マニュアルのPDFを一括で読み込ませ、「42分あたりの役員発言と、マニュアル12ページの仕様に矛盾はないか」と問えば、該当フレームと文章の該当箇所を即座に特定して提示できる。Google Workspaceとの統合によって、スプレッドシートのグラフとスライドの視覚的意匠を突き合わせた業務検証が日常的に行われるようになった。
そして2026年最新マルチモーダル技術動向に目を向けると、処理の舞台はクラウドから「エッジ端末」と「ロボティクス」へと急激に拡張している。スマートフォンやノートPCに搭載された最新NPU(ニューラル処理ユニット)上で小型マルチモーダルモデル(SLM)が軽快に動作し、機密データを外部サーバーに送信することなくローカル環境でリアルタイムの画面・音声監視が可能になった。さらに、視覚・音声情報を行動コマンドへと直接変換する「VLA(Vision-Language-Action)モデル」の台頭により、産業用アームロボットや人型ロボットが「散らかった机の上の青いペンだけを取って引き出しに入れて」という自然言語とカメラ映像の組み合わせから直接動作する環境が実用化フェーズに入っている。
【実態検証】利用者の生の声と現場目線で見えたリアル|マルチモーダルAI活用事例まとめ
技術の進化は目覚ましいが、実際の現場ではどのように役立てられているのか。国内の導入現場やエンジニアコミュニティ(Qiita、GitHub、SNS等)に集まる実態データを徹底検証すると、成果を上げている組織と苦戦している組織のコントラストがはっきりと見えてくる。ここでは代表的なマルチモーダルAI活用事例まとめを紹介する。
① 医療・介護現場でのカルテ・画像統合診断支援
複数の大学病院や先端クリニックで導入が進むのが、患者の問診音声、電子カルテのテキスト履歴、そしてレントゲンやCTスキャン画像を同時に読み込ませる診断アシスタントだ。医師が「前回の撮影から肺下部に影が広がっているように見えるが、過去の血液検査データと併せてどう評価できるか」と問いかけると、画像上の微細な陰影変化を指し示しながら、関連する過去の処方履歴を瞬時に引用する。都内総合病院の放射線科医は「画像単体では見落としそうだった初期病変を、患者の『先週から続く微熱』という問診音声データと紐づけて警告してくれた。二重チェックの精度が格段に向上した」と証言している。
② 製造業・フィールド保守におけるスマートグラス連動
プラント保守や工作機械のメンテナンス現場では、作業員が装着したスマートグラス越しに見ている配管や計器のライブ映像をAIがリアルタイム解析するシステムが定着しつつある。異音が発生している現場で「このバルブの締め付けトルク値は適正か」と作業員が呟くだけで、AIは機械の型番を目視で識別しつつ、稼働音の周波数スペクトルを分析。「異音から判断してパッキンの摩耗率が80%を超えています。即時交換が必要です」と視界上に作業手順をAR表示する。これにより、熟練工の勘と経験に頼っていた現場の技術伝承問題が大きく解消された。
③ 広告・Eコマースにおけるクリエイティブ自動生成・検証
EC大手や広告代理店では、商品画像、ブランドのトーン&マナー指針、過去の購買ログを投入し、バナー画像とキャッチコピーをセットで自動生成するだけでなく、「この配色とフォントは、ターゲット層の視線誘導モデルにおいてクリック率を向上させるか」を視覚的にセルフ検証させる運用が定着している。従来はデザイナーとコピーライターが数日かけていたABテストの試作サイクルが、わずか数時間に短縮された。
しかし一方で、現場のコミュニティからはリアルな苦言も噴出している。大手製造業のDX担当者が「現場の作業音があまりにもうるさい工場内では音声認識が破綻し、スマートグラスのバッテリーも2時間持たない」「解像度の高い動画を常時APIに流し続けた結果、初月のクラウド利用料が想定の5倍に跳ね上がった」と打ち明けるように、マルチモーダルAIビジネス導入理由を明確に定義しないまま技術の話題性だけで飛びついた現場では、コストと実用性のギャップに喘ぐケースも散見される。
一般に知られていない盲点とネットの誤解|マルチモーダルAIのメリットと課題
ネット上の言説やマーケティング資料では「マルチモーダルAIがあらゆる知覚を統合し、人間の知能を完全に超越した」かのような過剰な期待が語られがちだ。しかし、情報工学および現場運用の観点からは、まだ解決されていない構造的な欠陥が存在する。マルチモーダルAIのメリットと課題を冷徹に見極めることが、ビジネスの意思決定には不可欠である。
ネット上で流布している代表的な誤解と、その技術的実情は次の通りだ。
誤解①:「画像や音声を与えればハルシネーションは完全に消滅する」
これは最も警戒すべき俗説である。複数モダリティによる相互チェックで誤認率は確かに低下したが、ゼロになったわけではない。むしろ厄介なのが「モダリティ間コンフリクト(Modality Conflict)」と呼ばれる現象だ。たとえば、契約書の画像データ内に書かれた日付(2026年3月)と、ユーザーが音声で吹き込んだ日付(2025年3月)が食い違っていた場合、AIがどちらの証拠を優先すべきか正しく重み付けできず、両者を奇妙に合成した架空の事実を出力してしまう事例が報告されている。
誤解②:「どんなデータでもそのまま放り込めばAIが勝手に意味を見出してくれる」
現場のエンジニアが直面する最大の壁は「アライメント(整合性)の欠如」だ。音声と動画のタイムスタンプが数秒ずれているだけで、AIは「どの発言のときにどの画面操作が行われたのか」を取り違える。Qiitaなどの技術検証記事でも頻繁に指摘されている通り、マルチモーダルAIの精度は、投入する非構造化データがいかに正確に同期・構造化されているかに極めて強く依存する。
さらに見過ごせないのが「深刻なプライバシー・コンプライアンスリスク」だ。従来のテキストAIであれば氏名や電話番号を正規表現でマスキング(匿名化)することは容易だった。しかしマルチモーダルAIにオフィス内の監視カメラ映像や会議の生音声を流し込む場合、背景に映り込んだ社員の顔、ホワイトボードの機密メモ、背後で交わされた他人の雑談までがモデルのコンテキストに取り込まれてしまう。どこまでをセンシティブ情報として保護するかというデータガバナンスの策定が、導入企業の大きな足かせとなっている。
【プロの結論】導入すべき現場・慎重になるべきケースの判断基準
膨大な現場取材と技術的限界を踏まえ、マルチモーダルAIをいま積極的に導入すべき組織と、時期尚早として慎重になるべきケースの判断基準を提示する。
【即座に導入・検証を進めるべきケース】
- 「非言語情報のロス」がそのまま致命的な損失に直結する業務:カスタマーサポートのクレーム対応(声の感情解析)、医療・介護の問診、設備保全の外観・異音検査など。
- 図表・PDF・レイアウト文書の読み解き作業が全体の30%以上を占めるバックオフィス:紙伝票や図面、複雑な決算短信をOCRと手作業で打ち直している組織。
- リアルタイムの現場ハンズフリー支援が求められる現場:両手が塞がる物流ピッキング、自動車整備、手術室補助など。
【現段階では慎重な姿勢を保つべきケース】
- 単にテキストの要約や定型メール作成が主目的の業務:従来のテキスト特化型LLM(GPT-4o miniなど)の方が圧倒的にコストが低く、応答も安定している。高額なマルチモーダルAPIを浪費する必然性がない。
- データガバナンスとセキュリティルールが未整備の組織:社内カメラ映像や会議音声をそのままクラウドAIに入力できる規程がない場合、情報漏洩や肖像権侵害のリスクが技術的便益を上回る。
- 推論結果に対して「100%の決定論的説明可能性」が法的に求められる業務:金融の自動与信審査や厳格な法的判断など、複数モダリティの複雑な重み付け過程を人間が完全に追跡できない領域での利用は避けるべきだ。

【マルチモーダルとは】に関するよくある質問(FAQ)
Q1:マルチモーダルAIと、これまでの従来のChatGPTは何が違うのですか?
A1:初期のChatGPTはテキスト(文字)のみを理解・出力する「シングルモーダルAI」でした。これに対して最新のマルチモーダルAIは、テキストだけでなく画像、図表、音声波形、動画などを同一の知能モデルの中で直接理解できます。たとえば「スマートフォンのカメラで壊れた部品を映しながら、口頭で『ここから変な音がする』と話しかける」といった、人間同士の対話と全く同じコミュニケーションが可能です。
Q2:マルチモーダルAIを利用すると、従来のAIよりも利用料金が高くなりますか?
A2:はい、一般的にコストは高くなります。API利用料の基準となる「トークン」の消費量が、文字情報に比べて画像や音声、動画では大幅に大きくなるためです。静止画1枚の解析で数十〜数百文字分のテキストと同等のコストがかかり、動画を流し続ければ費用は急増します。したがって、日常的なテキスト処理には安価な軽量モデルを使い、視覚や音声が必要な局面でのみマルチモーダルモデルを呼び出す「モデルの使い分け」が実務では鉄則となっています。
Q3:自社のビジネスにマルチモーダルAIを組み込む際、最大の障壁は何ですか?
A3:最大の壁は「入力データの質とプライバシー管理」です。社内のマニュアルや現場映像、音声データが整理・同期されていないと、AIは文脈を正しく解釈できません。また、現場カメラの映像や顧客の音声を扱う際の肖像権・個人情報保護の社内ガイドライン策定や、モダリティ間の情報矛盾によって誤認が生じた際の責任の所在をどう担保するかが実用化の最大のボトルネックとなっています。
まとめ:五感を獲得したAIとどう向き合うべきか
テキストという抽象記号の世界に閉じこもっていた人工知能は、画像、音声、動画を統合処理するマルチモーダル技術の確立によって、ついに現実の物理世界を直接観察し、対話する「五感」を手に入れた。GPT-4oやGoogle Geminiが示した圧倒的な即答性と知覚統合は、業務自動化の対象をホワイトカラーのデスクワークから、フィールドワーク、製造ライン、医療現場へと一気に押し広げている。
しかし、万能に見える技術だからこそ、その影にある計算コストの増大、モダリティ間の情報コンフリクト、そしてデータガバナンスの壁から目を逸らしてはならない。マルチモーダルAIの真価は「すべてのタスクをこれ1つでこなすこと」ではなく、「視覚や聴覚が欠かせない現場のボトルネックをピンポイントで打ち砕くこと」にある。自社のどの業務に真の「感覚統合」が必要なのかを冷静に見極める視線こそが、これからのAI時代において決定的な競争優位を生み出す鍵となる。 (出典: マルチ モーダル と は(Yahoo!ニュース))
最新のトレンドや話題のニュースをわかりやすく解説するWebライターです。読者の皆様に役立つ情報を日々お届けしています。
