相関係数とは?目安やエクセル計算から因果関係の罠まで徹底解説
ビジネスの会議室から学術論文の査読まで、データ活用の現場で最も頻繁に飛び交う指標の一つが「相関係数」です。「広告費を増やせば売上も伸びるのか」「社員の残業時間と離職率に関連はあるのか」といった疑問に対し、2つのデータの結びつきを客観的な数値で示してくれる頼もしい道具と言えます。
しかし現場では、計算された数字の表面だけをなぞり、誤った施策に数千万円の予算を投じてしまうケースが後を絶ちません。原因の多くは、「相関関係」と「因果関係」を無意識に混同してしまう認知の罠や、外れ値による見せかけの数値に騙されることにあります。本稿では、相関係数の基礎的な計算ロジックから実務で直面する落とし穴の回避策まで、データ分析の第一線で求められる実践知を余すところなく解き明かします。
📌 【この記事の重要ポイントまとめ】
- 要点1:相関係数は「2つの変数の直線的な連動性」を-1から+1の範囲で表す指標であり、0に近いほど直線的な関係が希薄になる。
- 要点2:「相関があること」は「原因と結果(因果関係)であること」を意味せず、潜伏変数が引き起こす疑似相関を見抜く視点が不可欠である。
- 要点3:エクセルではCORREL関数で瞬時に算出できるが、必ず散布図による視覚化と無相関検定を併用し、外れ値の歪みを防ぐ必要がある。
【基礎知識】相関係数とは何か?2つのデータの直線的なつながりを測る物差し
相関係数(英語:correlation coefficient)は、2つの異なる変数間にどれほど「直線的な連動関係」があるかを数値化した統計指標です。一般に実務や統計学で単に「相関係数」と呼ぶ場合、英国の統計学者カール・ピアソンが考案したピアソンの積率相関係数(記号:$r$)を指します。
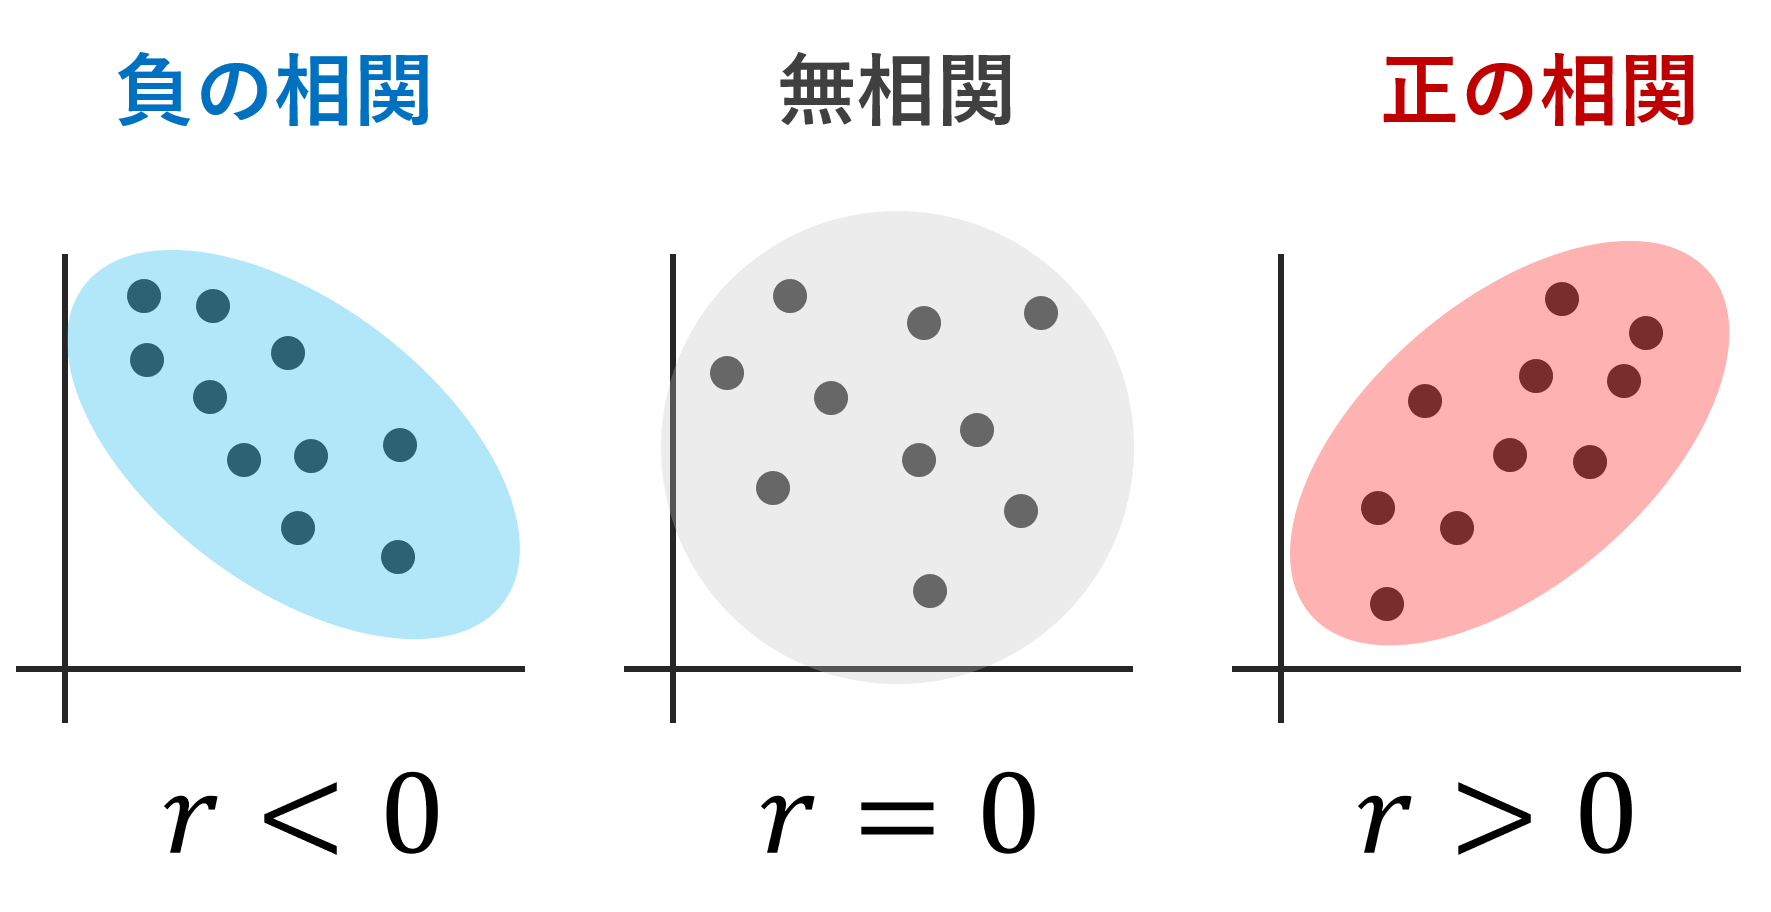
相関係数は必ず-1.0から+1.0の間に収まります。この数値の符号と大きさによって、データの関係性は大きく2つの方向に分かれます。
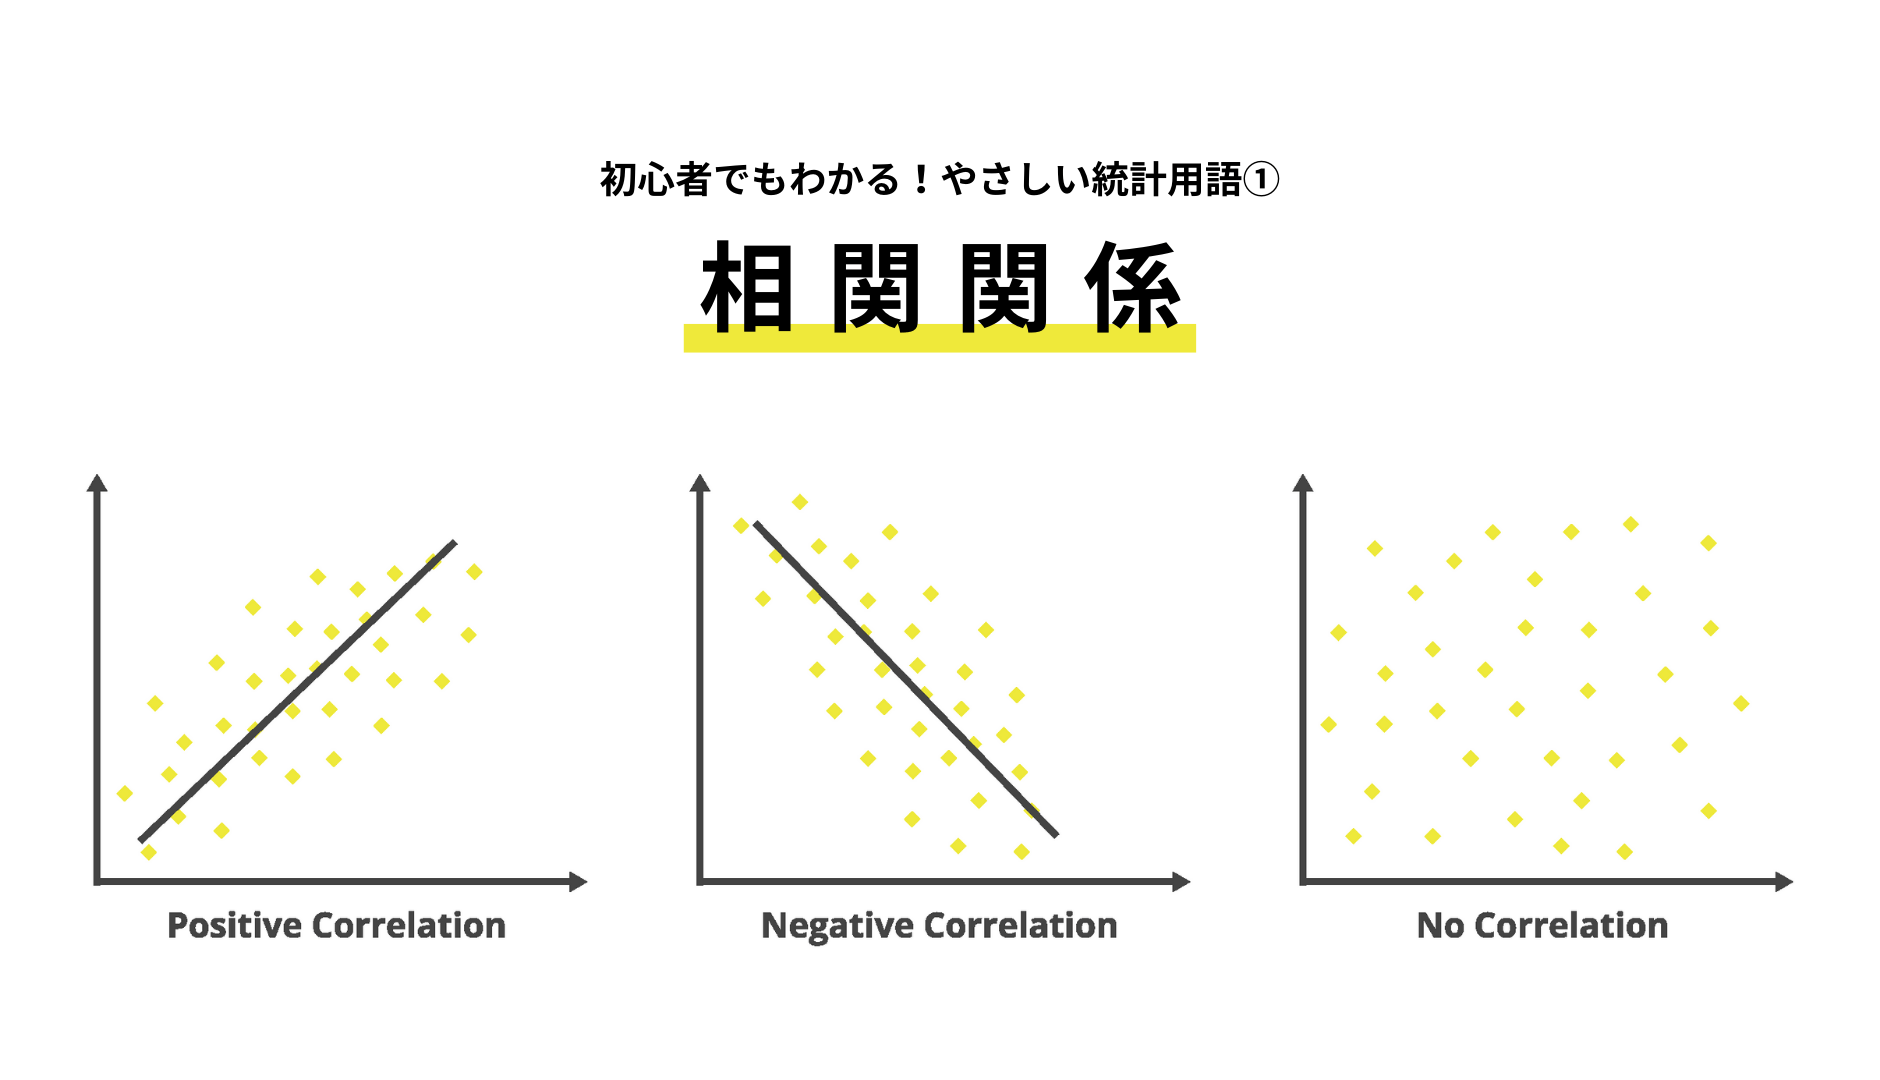
- 正の相関(0 < r ≦ 1):一方のデータが増加すると、もう一方のデータも増加する傾向。「気温の上昇に伴うアイスクリームの売上増」や「勉強時間と試験の点数」が典型例です。
- 負の相関(-1 ≦ r < 0):一方のデータが増加すると、もう一方のデータは減少する傾向。「標高が高くなるにつれて低下する気圧」や「商品の値上げ幅と購入点数」に見られます。
- 無相関(r ≒ 0):一方の増減が他方の増減に直線的な影響を及ぼさない状態。「靴のサイズと数学のテストの点数」のように、互いに関連がない状態を指します。
ここで押さえておきたいのが、共分散と相関係数の関係です。2つの変数の偏差(平均値からのズレ)同士を掛け合わせた平均を「共分散」と呼び、これがプラスなら正の相関、マイナスなら負の相関の傾向を示します。しかし共分散は、「円」や「キログラム」といった単位の大きさに数値が左右され、異なるデータ同士で比較ができません。そこで、共分散をそれぞれの変数の標準偏差の積で割ることにより、単位の影響を排除して「-1から+1」に規準化したものが相関係数です。
【数値の目安】相関係数の目安と解釈|「0.7以上なら強い」の真実をデータ比較
実務で相関係数を算出した際、多くの人が「この数値は高いと言えるのか」という解釈の壁に直面します。統計学の教科書やビジネス分析では一定の基準値が共有されていますが、扱うデータのノイズ量によって慎重に判断しなければなりません。
以下の表は、一般的な相関係数の目安と解釈を、現場での実用的な評価基準とともに整理したものです。
| 相関係数の範囲(絶対値 |r|) | 詳細・数値データ | 一般的な基準・相場 | 編集部の見解・評価 |
|---|---|---|---|
| 0.7 〜 1.0(-0.7 〜 -1.0) | 非常に強い直線的連動 | 強い相関あり | 現場でも明確な関係性を確信できる水準。ただし同義語的なデータの重複に注意。 |
| 0.4 〜 0.7(-0.4 〜 -0.7) | ある程度の傾向が見られる | 中程度の相関あり | マーケティングやアンケート調査では十分な成果指標になり得る現実的な数値。 |
| 0.2 〜 0.4(-0.2 〜 -0.4) | かすかな連動がうかがえる | 弱い相関あり | 単独での因果推論は困難。他の要素が強く介入している可能性が高い。 |
| 0.0 〜 0.2(-0.2 〜 0.0) | 直線的な連動がほぼ皆無 | ほとんど相関なし | 直線的な関係は否定されるが、後述する非線形関係が隠れている余地はある。 |
注意すべきは、サンプルサイズ(データ数 $n$)の規模です。データがわずか5個しかない場合、たまたま直線上近くに並んで $r = 0.85$ という高い数値が出てしまう現象が珍しくありません。逆に1万人規模の大規模データでは、$r = 0.15$ であっても偶然とは言えない確固たる関係性として検出される場合があります。
こうした偶然の産物を排除するために使われるのが無相関検定のやり方です。「母集団の相関係数は本来ゼロである」という帰無仮説を立て、t分布を用いた検定統計量を算出します。得られたp値が有意水準(一般に5%や1%)を下回って初めて、「統計的に意味のある相関関係が認められる」と論証できるのです。
【致命的落とし穴】因果関係との違いと「疑似相関」の恐ろしい罠を暴く
データ初心者が最も陥りやすく、かつビジネスや政策決定において致命傷をもたらすのが因果関係との違いの混同です。「AとBの間に強い相関がある」ことと、「Aが原因でBという結果が起きた」ことは、まったく次元の異なる概念です。
代表的な事例が疑似相関の落とし穴です。2つの変数の間にあたかも関係があるように見えて、実は背後に潜む「第3の変数(交絡因子)」が両方を同時に動かしている現象を指します。
古典的な例として知られるのが「アイスクリームの売上」と「水難事故の件数」の相関です。データを集計すると、両者には $r = 0.8$ を超える強い正の相関が観測されます。しかし、「水難事故を減らすためにアイスクリームの販売を禁止しよう」と判断する人はいません。背後に「夏の気温上昇」という真の原因が存在し、気温が上がった結果としてアイスの売上が増え、同時に海水浴客が増加して水難事故が増えているだけだからです。
ビジネスの現場でも、これと酷似した錯覚が頻発します。「自社オウンドメディアの閲覧回数が多い顧客ほど、製品の年間購入額が高い」というデータを得たマーケティング部門が、閲覧数を増やす施策に巨額を投じたものの、売上が全く伸びないといったケースです。この場合も「もともと自社製品への愛着度(ロイヤルティ)が高い」という第3の変数が、記事の閲覧と購買行動の双方を引き起こしていたに過ぎません。
人間には、無秩序なデータの中に意味や物語を自動的に見出そうとする心理的傾向(アポフェニアや確証バイアス)が備わっています。「相関が見つかった瞬間に、頭の中で勝手な原因と結果のストーリーを組み立てていないか」という内省的な疑いを持つことが、アナリストに求められる最低限の倫理です。

【実践ガイド】エクセルCORREL関数での求め方と外れ値の影響・注意点
実務で相関係数を求める際、最も手軽で多用されているのが表計算ソフトの活用です。Microsoft Excelでは、標準で用意されているエクセルCORREL関数を用いることで、複雑な公式を手計算することなく一瞬で数値を導き出せます。
基本構文は極めてシンプルです。
=CORREL(配列1, 配列2)
例えば、セルB2からB31に「広告費」、セルC2からC31に「新規獲得件数」が入力されている場合、空いているセルに =CORREL(B2:B31, C2:C31) と入力するだけで、2変数間の相関係数が返されます。なお、PEARSON関数という同等の計算を行う関数も存在しますが、仕様や計算結果は同一です。
しかし、関数を打ち込んで数値を手に入れただけで満足してはいけません。実データを取り扱う上で最大の障害となるのが外れ値の影響と注意点です。
ピアソンの積率相関係数は、平均値からの二乗誤差をベースに計算されるため、極端にかけ離れた「たった1点」の特異なデータに数値を激しく歪められます。例えば、全体としては全く相関がないデータ群の中に、両方の変数が異常に大きな「巨大企業1社」のデータが混ざり込むと、それだけで相関係数が 0.1 から 0.8 へと急上昇してしまうのです。
これを回避するための鉄則が、計算前に必ず散布図の見方をマスターし、グラフを描画することです。縦軸と横軸にデータをプロットした散布図を確認すれば、以下の異常事態を一目で察知できます。
- 右上の隅にポツンと1点だけ離れた外れ値が存在していないか
- 相関係数が0に近いにもかかわらず、散布図上ではきれいな「U字型」や「逆U字型(放物線)」を描いていないか(ピアソンの相関係数は直線関係しか測れないため、強い曲線関係を見落とします)
- データが複数のグループに分かれて二極化していないか
もしデータ内に外れ値が多く含まれる場合や、顧客満足度ランキングのようにデータ自体が順位やアンケートの評点(順序尺度)である場合は、スピアマンの順位相関係数の採用を検討します。スピアマンの手法は、実数値をそのまま計算するのではなく「順位(ランク)」に変換してから相関を測るノンパラメトリック手法であるため、外れ値の極端なブレに対して極めて頑健(ロバスト)という強みを持っています。
【実態検証】利用者の生の声と現場目線で見えたリアル
データ分析ツールが誰でも扱える時代になったからこそ、社内の意思決定現場では相関係数の扱われ方をめぐる悲喜こもごもが観察されます。大手事業会社やDX推進部門の現場担当者からは、次のような切実な証言が聞こえてきます。
「経営会議で『残業時間と営業成績の間に負の相関(-0.65)が出たため、残業を一律禁止にすれば売上が上がります』とプレゼンした新任マネージャーが、役員から『それは残業を減らしたから成績が伸びるのか? それとも優秀な営業マンが仕事を効率化して早く帰っているだけじゃないのか?』と一蹴された現場を目撃した」(大手IT・事業企画担当者)
「アンケートの5段階評価データをそのままエクセルのCORREL関数に入れて『相関が出ました』と報告してくる部下が多い。リッカート尺度の順序データを無批判に積率相関にかけるリスクや、母集団の偏りを確認する散布図の作成を徹底させるのに毎年苦労している」(マーケティングリサーチ会社・チーフアナリスト)
SNSやエンジニアコミュニティでも、「相関係数」という単語はしばしばバズワード化する一方で、その解釈をめぐる議論が絶えません。データサイエンティストたちの共通見解は一貫しています。「$r$ の値だけをスライドに貼るな。散布図のスクショを隣に並べろ」。これは、現場で数多くの誤謬に泣かされてきた専門家たちの共通の知恵と言えます。
一般に知られていない盲点とネットの誤解
インターネット上の解説記事や初歩的な解説動画では、「相関係数が0ならば関係性はない」と短絡的に片付けられているケースが散見されます。しかし、これは統計学上、極めて危険な誤解です。
ピアソンの相関係数は、あくまで「一次関数(直線 $y = ax + b$)のフィッティングの良さ」を測る指標に過ぎません。例えば、心理学で有名な「逆U字型」の関係(適度なストレスがある時に最も作業パフォーマンスが高まり、低すぎても高すぎても効率が落ちるというヤーキーズ・ドットソンの法則)では、散布図を描くと見事な放物線を描きます。しかし、これをCORREL関数で計算すると、プラスとマイナスが相殺し合って相関係数はほぼ0になります。
「相関係数がゼロだから無関係」と早合点して施策を打ち切ると、そこに存在していた極めて重要な非線形ルールを丸ごと捨て去ることになりかねません。数字の単一化がもたらす情報落ちの恐ろしさを自覚しておく必要があります。
【プロの結論】相関係数を使いこなす人・振り回される人の判断基準
統計データを武器にして成果を出す人と、数字の魔力に振り回されて組織をミスリードする人。その境界線はどこにあるのでしょうか。実務で判断を誤らないための明確なクライテリアを提示します。
- 相関係数を正しく使いこなせる人の条件:
- 数値を計算する前に、必ず散布図を描いてデータ分布の歪みや外れ値を目視している。
- 相関を見つけた際、「逆の因果関係(Bが原因でAが起きた)」や「交絡因子(共通の真因C)」の存在を真っ先に疑う習慣がある。
- サンプルサイズを意識し、無相関検定によるp値の確認を怠らない。
- データの尺度(間隔尺度・比率尺度か、順序尺度か)に応じて、ピアソンとスピアマンを的確に使い分ける。
- 相関係数の数字に振り回されて失敗する人の条件:
- エクセルの計算結果(単一のセルに出た数字)だけを見て、中身の分布を見ようとしない。
- 「相関が高い=原因である」と飛躍し、打ち手を変えれば結果が劇的に好転すると信じ込む。
- 数件〜十数件程度のわずかなデータで出た $r = 0.8$ を過信して経営判断に持ち込む。
以下に、実務で迷った際に役立つ統計学基礎用語まとめをコンパクトに整理しておきます。
- 共分散:2つのデータのばらつきが同じ方向に連動している度合いを示す値。単位の影響を受ける。
- 標準偏差:データが平均値からどれくらい散らばっているかを示す尺度。
- 散布図:縦軸・横軸に2変数を配置して打点したグラフ。直線関係、外れ値、非線形構造を暴く必須ツール。
- 無相関検定:母集団において「相関がゼロである」という仮説を検証し、偶然の相関を排除する検定手続き。
- 交絡因子:原因と結果の両方に影響を与え、見かけ上の相関(疑似相関)を生み出す第三の変数。
【相関係数とは】に関するよくある質問(FAQ)
Q1:相関係数がマイナスになった場合、データとしては悪い兆候なのですか?
A1:いいえ、マイナスの符号は「良し悪し」を意味するものではなく、単に「一方の数値が増えると、もう一方が減る」という逆方向の連動性(負の相関)を示しています。例えば、「自動車の車両重量」と「燃費(km/L)」の間には強い負の相関(マイナスの相関係数)が現れますが、これは物理法則として極めて自然で正常なデータです。
Q2:相関係数が高ければ、回帰分析で将来予測を行っても問題ありませんか?
A2:相関が高いことは線形回帰分析を検討する上での好材料ですが、それだけで予測モデルを確定させるのは早計です。疑似相関でないことの論理的裏付けはもちろん、残差(予測値と実測値の差)が正規分布しているか、多重共線性が生じていないかなど、追加の診断手続きを経る必要があります。
Q3:データが10件程度しかない場合、相関係数は算出しても無意味でしょうか?
A3:参考値として計算することは可能ですが、信頼性は非常に低くなります。サンプルサイズが10件前後の場合、母集団が無相関であっても、偶然によって $r = 0.6$ 程度の高い値が出現することが統計的に珍しくありません。サンプル数が少ない場合は、必ず無相関検定を実施してp値を確認し、偶然の産物でないかを統計学的に精査してください。
まとめ:今後の動向と失敗しないための判断基準
生成AIや高度なデータ解析基盤がビジネスインフラとなった現代においても、すべてのデータサイエンスの原点は「相関と因果の峻別」に集約されます。どれほど高度な機械学習アルゴリズムを導入しようとも、入力データが持つ疑似相関の罠や外れ値のノイズを見落としていれば、導き出される示唆は無価値どころか有害なものになります。
エクセルのCORREL関数で導き出される1つの数値は、データ探索の旅における「出発点」に過ぎません。まずは散布図を描いてデータの生々しい息遣いを目で確かめ、統計的検定で偶然性を排除し、背後にある因果のメカニズムへと思考を巡らせること。この泥臭くも誠実な検証プロセスの積み重ねこそが、数字の魔力に騙されず、ビジネスで本質的な価値を生み出すための唯一の道筋です。 (出典: 相 関係 数 と は(Yahoo!ニュース))
最新のトレンドや話題のニュースをわかりやすく解説するWebライターです。読者の皆様に役立つ情報を日々お届けしています。
