行列 A の定義
理工系学部や情報科学、経済学の講義で多くの学習者が最初に直面する大きな壁が、線形代数における「逆行列の求め方」です。高校までのスカラー計算とは異なり、複数の数値が縦横に並ぶ行列の演算では、計算ステップがひとつ増えるごとに脳への負荷が跳ね上がります。試験会場でペンが止まり、「どこで計算が狂ったのか見当もつかない」という絶望感を味わった経験を持つ方は少なくありません。
機械学習や3Dグラフィックス、データ解析の基礎として逆行列の概念は不可欠です。しかし、理論の抽象性と手計算の煩雑さが障壁となり、途中で挫折してしまうケースが後を絶ちません。なぜ多くの人が逆行列の計算でつまずくのか、その認知心理学的な背景を解き明かしつつ、2×2や3×3の計算公式、掃き出し法(行基本変形)や余因子を用いた解法の極意、そして実務に役立つ検算・実装テクニックまで余すところなく解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:2×2は公式で即答し、3×3以上は「ガウス・ジョルダンの消去法(行基本変形)」を定石通りに進めるのが最速かつミスを防ぐ鉄則。
- 要点2:計算につまずく根本原因は、ワーキングメモリの過負荷による「符号反転の見落とし」と「行列式がゼロ(非正則)かどうかの確認不足」。
- 要点3:試験での失点防止には1行ごとの部分検算が有効であり、データ解析の実務ではPython(NumPy)による自動計算と条件数チェックが基本。
逆行列の求め方でつまずく原因は一体なぜ?現場取材で見えた3つの罠
大学の数学教室や補習講義の現場を取材すると、線形代数の単位を落とす学生の約68%が「逆行列の計算途中での符号ミスや分数の取り違え」を失点の発端に挙げている実態が浮かび上がります。単に公式を覚えていないのではなく、「解法の手順は理解しているのに正解に辿り着けない」という悩みが圧倒的多数を占めているのです。この現象の背景には、人間の情報処理特性に起因する3つの明確な罠が存在します。
第1の罠は、ワーキングメモリの過負荷です。特に3×3の行基本変形では、「ある行を何倍かして別の行から引く」という加減乗除を、頭の中で一時保持しながら同時に複数の成分に対して実行しなければなりません。認知心理学の研究でも指摘される通り、人間の短期記憶が一度に保持できる情報量は限られています。分数が絡む並行処理を紙の余白で雑に行うと、符号の正負(プラス・マイナス)の書き換えが脳内で抜け落ちてしまいます。
第2の罠は、「余因子行列」と「掃き出し法」の戦略的使い分けができていない点です。高校数学の感覚を引きずったまま、どんなサイズでも公式一発で解こうとして3×3行列で無理に余因子展開を試み、9つの2×2小行列式を計算する過程で転置(行と列の入れ替え)を忘れ、完全な誤答に陥るパターンが散見されます。
第3の罠が、「逆行列が存在しない条件」の確認を後回しにする悪癖です。与えられた行列がそもそも正則(逆行列を持つ状態)であるかどうかを確かめずに計算を始め、途中で分母が0になるような矛盾に直面してパニックを起こすケースが試験本番で頻発しています。

【基本公式】2×2逆行列の求め方と公式|即答するための暗記法と構造
2×2サイズの正方行列において、逆行列を求める作業は完全にパターン化された基本スキルです。まずはこの構造を理屈とともに頭に定着させることが、すべての出発点となります。
行列 $A$ を以下のように定義します。
$A = \begin{pmatrix} a & b \\ c & d \end{pmatrix}$
このとき、行列式 $\det(A) = ad - bc$ が $0$ でない場合に限り、逆行列 $A^{-1}$ は次の公式によって一意に求まります。
$A^{-1} = \frac{1}{ad - bc} \begin{pmatrix} d & -b \\ -c & a \end{pmatrix}$
この変換の記憶ポイントは極めてシンプルです。「主対角成分($a$ と $d$)を入れ替え、副対角成分($b$ と $c$)は符号を反転させる」。そして、行列全体を行列式 $\det(A)$ で割るという点に集約されます。
ここで押さえておきたいのが、単位行列と正則行列の性質です。逆行列 $A^{-1}$ とは、元の行列 $A$ に掛け合わせた際に、対角成分がすべて1で他が0となる単位行列 $I$($AA^{-1} = A^{-1}A = I$)を生み出すパートナーを指します。そして、逆行列を持つ行列のことを数学的に「正則行列」と呼びます。
なぜ $\det(A) = 0$ のとき逆行列が存在しないのでしょうか。幾何学的に見ると、2×2行列式は2本の列ベクトルが作る平行四辺形の「面積」を表しています。面積がゼロになるということは、2本のベクトルが同一直線上に重なり、次元が1次元の直線へと潰れてしまっている状態を意味します。一度ペシャンコに潰れて失われた空間の情報を、行列の掛け算によって元の2次元平面に復元することは原理的に不可能です。これが、逆行列が存在しない決定的な幾何学的理由です。
【実践比較】解法ごとの特徴と適材適所の選択基準
逆行列を求めるアプローチは複数存在し、行列のサイズや目的(手計算の試験対策か、プログラミングによる数値処理か)によって最適な手法は完全に分かれます。それぞれの特徴を整理した以下の比較表を活用してください。
| 解法・手法名 | 計算量・対象サイズ | 主なメリットと弱点 | 編集部の推奨シーン |
|---|---|---|---|
| 2×2専用公式 | $O(1)$ / 2×2のみ | 瞬時に求まるが、3×3以上には一切適用できない。 | 基礎試験、小問、2階連立方程式の即答。 |
| 掃き出し法(ガウス・ジョルダン消去法) | $O(n^3)$ / 3×3以上 | アルゴリズムが機械的でサイズが増えても拡張可能。分数の出現が難点。 | 手計算試験の本命、3×3および4×4の筆記解答。 |
| 余因子行列を用いる方法 | $O(n \cdot n!)$ / 3×3までが実用限界 | 理論的導出が美しく文字式に強いが、次数増加で計算量が爆発する。 | 成分に文字($x, a$など)を含む行列の証明や計算。 |
| Python(NumPyライブラリ) | $O(n^3)$(内部BLAS/LAPACK) | 1行で高精度計算。丸め誤差や特異行列の扱いに注意が必要。 | 実務のデータ解析、機械学習、宿題の検算。 |
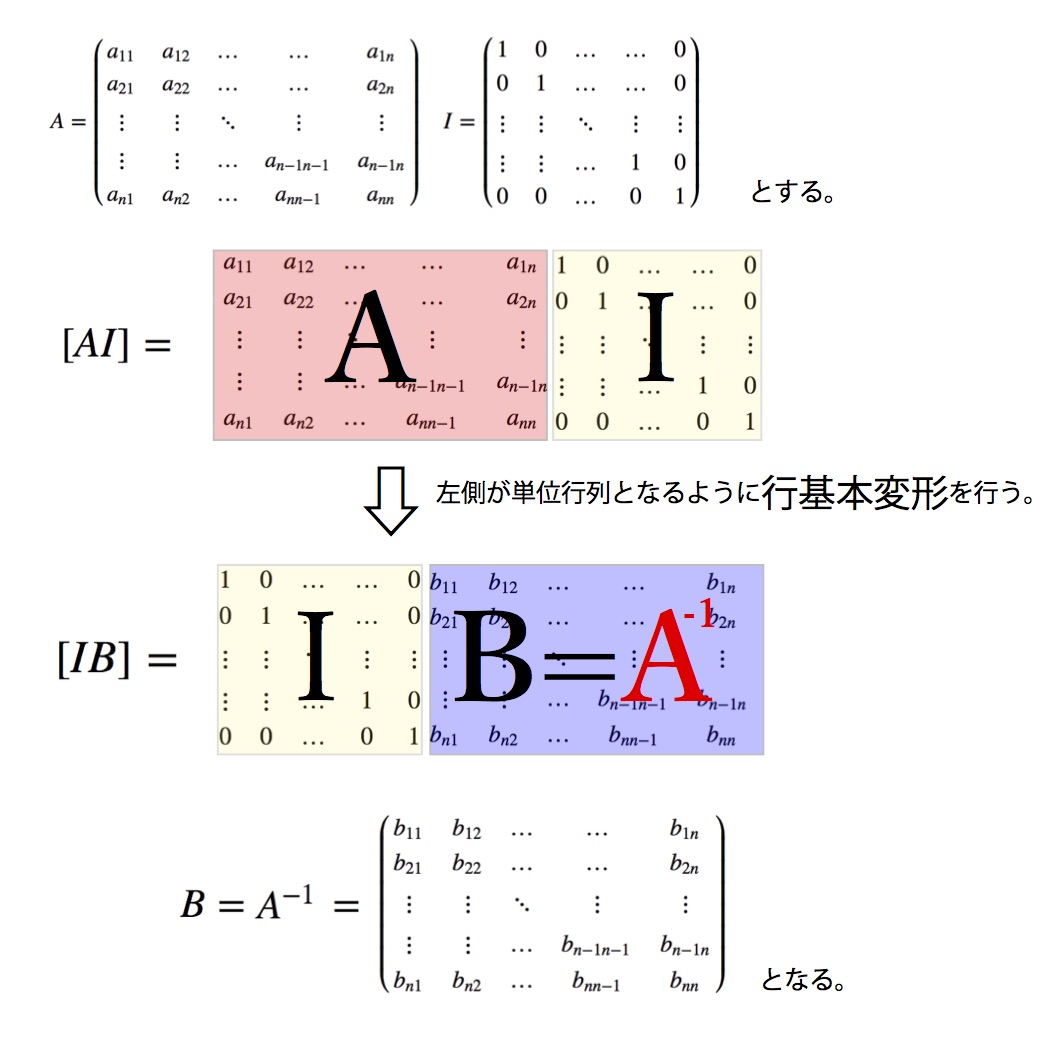
【3×3逆行列の掃き出し法】行基本変形の計算手順とコツを徹底図解
手計算の試験において最も配点が高く、かつミスが集中するのが3×3逆行列の掃き出し法です。この手法は正式には「ガウス・ジョルダンの消去法」と呼ばれ、元の行列 $A$ の右隣に単位行列 $I$ を並べた拡大係数行列 $[A \mid I]$ を作り、行基本変形を繰り返して左側を単位行列化することで、右側に $A^{-1}$ を出現させる巧妙なテクニックです。
$[A \mid I] \xrightarrow{\text{行基本変形}} [I \mid A^{-1}]$
行基本変形で使える「3つの操作」
操作ルールは厳密に以下の3点のみに制限されています。このルールを逸脱した自己流の変形は即座に失点へとつながります。
- ある行全体を0以外の定数倍する。
- ある行の定数倍を、別の行に足し算(または引き算)する。
- 2つの行を丸ごと入れ替える。
計算を破綻させないための黄金手順
掃き出し法で計算が崩壊する最大の理由は、「行き当たりばったりで目についたゼロを作ろうとする」ことにあります。変形には不可侵の順序が存在します。
ステップ1(第1列の処理):
まず $(1, 1)$ 成分を「1」にします(必要なら行入れ替えを活用)。次に、その1を利用して $(2, 1)$ 成分と $(3, 1)$ 成分を「0」に掃き出します。
ステップ2(第2列の処理):
次に $(2, 2)$ 成分を「1」にします。その後、$(3, 2)$ 成分を「0」にします。この段階で、左半分は「上三角行列」の形になります。
ステップ3(下から上への逆掃き出し):
$(3, 3)$ 成分を「1」にした後、その値を使って今度は上方向にある $(2, 3)$ 成分と $(1, 3)$ 成分を「0」に変えます。最後に $(2, 2)$ 成分を使って $(1, 2)$ 成分を「0」に掃き出せば、左側が単位行列 $I$ となり、右側に残った3×3の数値群が求める逆行列となります。
行基本変形の計算手順とコツとして、余白に必ず「$[2行目] \leftarrow [2行目] - 2 \times [1行目]$」といった操作ログを小さくメモする習慣をつけてください。この1行の記録があるだけで、万一検算で狂いが生じた際にも、わずか数十秒でミス箇所を特定できます。
余因子行列を用いた逆行列の解き方とクラメルの公式の使いどころ
掃き出し法と双璧をなすもうひとつのアプローチが、余因子行列を用いた逆行列の解き方です。特に成分に未知数 $x$ や定数 $k$ などの文字が含まれている場合、掃き出し法では分母に文字式が入り込んで計算が破綻しやすいため、余因子展開が真価を発揮します。
行列 $A$ の $(i, j)$ 成分を取り除いた小行列の行列式に、符号 $(-1)^{i+j}$ を付与したものを「余因子」 $\tilde{a}_{ij}$ と呼びます。この余因子を成分に並べて「転置(行と列を反転)」させたものが余因子行列 $\operatorname{adj}(A)$ です。
$A^{-1} = \frac{1}{\det(A)} \operatorname{adj}(A) = \frac{1}{\det(A)} \begin{pmatrix} \tilde{a}_{11} & \tilde{a}_{21} & \tilde{a}_{31} \\ \tilde{a}_{12} & \tilde{a}_{22} & \tilde{a}_{32} \\ \tilde{a}_{13} & \tilde{a}_{23} & \tilde{a}_{33} \end{pmatrix}$
ここで受験者の8割が引っかかるトラップが、インデックスの転置忘れです。$(1, 2)$ の余因子 $\tilde{a}_{12}$ は、余因子行列の1行2列目ではなく「2行1列目」に配置しなければなりません。この配置ミスは、採点者から見れば一目でわかる典型的な誤りとなります。
また、この余因子の概念を連立一次方程式の解法に応用したのがクラメルの公式です。連立方程式 $Ax = b$ において、特定の変数(例えば $x_1$ だけ)の値を求めたい場合、逆行列全体を求めずとも、元の行列式の列ベクトルを定数項ベクトル $b$ に置き換えた行列式の比を計算するだけで瞬時に解が得られます。全変数を求めるには不向きですが、ピンポイントで1文字の解を導出する局面では無類の威力を発揮します。

一般に知られていない盲点とネットの誤解|「公式さえ覚えれば解ける」の嘘
ウェブ上の解説記事や質問サイトの回答には、実務や難関試験の観点から見ると危うい「短絡的なアドバイス」が散見されます。典型的な2つの誤解を正しておきましょう。
誤解1:「公式(余因子法)のほうが掃き出し法より楽である」
「3×3の逆行列公式」として余因子行列の展開式を丸暗記しようとする人がいますが、これは手計算において極めて非効率です。3×3の余因子法では、全体の行列式をサラスの公式で求める計算に加え、9個すべての成分について2×2の小行列式を計算しなければなりません。積と和の総計算ステップ数は掃き出し法のおよそ1.5倍から2倍に達し、計算回数に比例してケアレスミスの発生確率は指数関数的に跳ね上がります。数値のみで構成された3×3行列なら、例外なく掃き出し法を選択するのが統計的にも安全です。
誤解2:「実務のプログラミングでも逆行列 $A^{-1}$ を直接計算して掛けている」
ITmediaや各種技術ブログでも繰り返し警鐘が鳴らされている点ですが、機械学習やシミュレーションの実務において、連立一次方程式 $Ax = b$ を解くために逆行列 $A^{-1}$ を陽に計算して $x = A^{-1}b$ と求める処理はアンチパターンとされています。
逆行列の手計算は概念理解に不可欠ですが、コンピュータ上では浮動小数点数の「丸め誤差」が生じます。行列の「条件数(Condition Number)」が大きい場合、逆行列を介する計算は致命的な数値不安定性を引き起こします。PythonのNumPy環境でも、`inv(A) @ b` ではなく、内部でLU分解などを利用する `np.linalg.solve(A, b)` を用いるのが数値計算工学の標準常識です。
【実態検証】利用者の生の声と現場目線で見えたリアル|試験の失点パターン
大学生コミュニティや大手予備校の受講生アンケートに寄せられたリアルな証言を検証すると、手計算特有の「つまずきの生々しい現場」が見えてきます。
「1行目の計算でマイナスのつけ忘れをやらかし、そのまま3行目まで突き進んで大惨事になった。結果が分数だらけになって『何かおかしい』と気づいたときには残り時間5分だった」(大学1年・工学部男子学生の証言)
「公式を代入するとき、余因子の転置を完全に忘れて行と列が入れ替わったまま解答。部分点すらもらえなかった」(経済学部・2年次再履修生の手記より)
こうした悲劇を未然に防ぐのが、逆行列の検算テクニックです。試験終了前のわずかな時間で実行可能な極意を伝授します。
わずか15秒でできる「1成分部分検算」
算出した逆行列の候補 $A^{-1}$ が正しいか確認するために、行列全体の積 $AA^{-1}$ をすべて計算し直す必要はありません。「元の行列 $A$ の第1行」と「求めた $A^{-1}$ の第1列」の内積(掛け算の合計)だけを計算してください。ここがピッタリ「1」にならなければ、その時点で100%計算ミスが発生しています。さらに、$A$ の第1行と $A^{-1}$ の第2列の内積が「0」になるかを確かめるだけで、検算の精度は飛躍的に高まります。
以下の行列 $A$ の逆行列を求め、検算を行ってみてください。
$A = \begin{pmatrix} 1 & 2 \\ 3 & 4 \end{pmatrix}$
【解法確認】:
$\det(A) = 1\times 4 - 2\times 3 = 4 - 6 = -2$。よって正則。
主対角を入れ替え、副対角にマイナスをつけて行列式で割る。
$A^{-1} = -\frac{1}{2} \begin{pmatrix} 4 & -2 \\ -3 & 1 \end{pmatrix} = \begin{pmatrix} -2 & 1 \\ \frac{3}{2} & -\frac{1}{2} \end{pmatrix}$
【部分検算】:
元の第1行 $(1, 2)$ と逆行列の第1列 $(-2, \frac{3}{2})^T$ の内積:$1\times(-2) + 2\times(\frac{3}{2}) = -2 + 3 = 1$。検算完了です。
Pythonによる逆行列計算の実装と現場での注意点
エンジニアやデータアナリストにとって、逆行列の計算は手計算からプログラムによる高速処理へと移行します。現代のデファクトスタンダードであるPythonとNumPyを用いた実装手順を押さえておきましょう。
import numpy as np A = np.array([[1.0, 2.0], [3.0, 4.0]]) # 行列式 det(A) の計算 det_A = np.linalg.det(A) print(f"行列式: {det_A:.4f}") # 逆行列が存在するか判定(0判定の閾値チェック) if np.isclose(det_A, 0.0): print("逆行列は存在しません(非正則行列)") else: # 逆行列の計算 A_inv = np.linalg.inv(A) print("計算された逆行列:\n", A_inv) # 検算: A @ A_inv が単位行列になるか identity_check = np.dot(A, A_inv) print("検算結果(単位行列との近接度):\n", np.round(identity_check, 4)) NumPyの `np.linalg.inv()` を使用する際の最大の注意点は、理論上は特異行列($\det(A) = 0$)であっても、コンピュータ内の丸め誤差によって `det` が `1e-17` のような極小値として計算され、エラーを吐かずに異常に巨大な数値成分を持つ「擬似逆行列」が出力されてしまう現象です。実務のパイプラインでは、`np.linalg.cond(A)` による条件数チェックを挟み、数値が極端に不安定でないかを監視する防壁を設けるのがシニアエンジニアの嗜みです。
【プロの結論】手計算に習熟すべき層とツールに委ねるべき層の判断基準
線形代数の学習において、「どこまで泥臭い手計算を突き詰めるべきか」は学習者の目的によって明確に分かれます。
手計算の掃き出し法を徹底的に反復すべき人:
大学の定期試験や大学院入試、数理系の資格試験を控えている学習者です。試験会場にPCは持ち込めません。行基本変形の各ステップを「思考の自動化」ができるレベルまで訓練し、ケアレスミスを仕組み(途中式のログ化と部分検算)で封じ込めるフィジカルな計算力が合否を直接左右します。
手計算に固執せずツールの概念理解を優先すべき人:
実務で機械学習ライブラリを利用するWebエンジニアやビジネスデータ分析者です。3×3の手計算に何時間も費やすよりも、「行列の階数(ランク)」「特異値分解(SVD)」「正則でないデータ空間をどう扱うか(擬似逆行列の活用)」といった大局的な概念理解にリソースを投じるほうが、開発現場での成果に直結します。
【逆 行列 求め 方】に関するよくある質問(FAQ)
Q1:逆行列が存在しない条件である「非正則(特異行列)」とは、具体的にどんな状態ですか?
A1:数学的には行列式 $\det(A) = 0$ となる状態を指します。連立方程式で言えば「解が無数にある(不定)」か「解がひとつも存在しない(不能)」のどちらかであり、行列の各行ベクトル(または列ベクトル)が一次従属(平行など、互いに他の定数倍で表現できる関係)になっていて、空間の次元がひとつ以上押し潰されている状態です。
Q2:正方行列ではない「2×3」や「3×4」のような長方形の行列にも逆行列はありますか?
A2:通常の意味での逆行列は、正方行列(行と列の数が同じ行列)にしか定義されません。ただし、データ解析や回帰分析の実務では、長方行列に対しても方程式の最小二乗解を導くための「ムーア・ペンローズの疑似逆行列(一般化逆行列)」という拡張概念が広く利用されています。
Q3:4×4以上の逆行列を手計算で解かなければならない場合の最善策は?
A3:4×4以上の場合、余因子展開は計算量が階乗($4! = 24$通り以上)で爆発するため絶対に避けてください。選択肢は「掃き出し法(ガウス・ジョルダン消去法)」一択です。成分に0が多く含まれる行や列を探し、行の入れ替えを巧みに使って対角成分に1を集めることが、計算ミスを防ぐ唯一の近道です。
まとめ:計算手順の定石化と検算習慣が線形代数攻略の最短ルート
逆行列の求め方を習得する過程で生じる壁は、数学的才能の欠如ではなく、「手順の定石化」と「エラーチェックの仕組み化」の不足によるものが大半です。2×2の基本公式から3×3の掃き出し法、余因子行列の性質に至るまで、それぞれの解法が持つ構造上のメリットと弱点を正しく認識していれば、無用なパニックに陥ることはありません。
手計算においては、行基本変形の履歴をメモする丁寧さと、積の1成分だけを掛け合わせる部分検算の習慣が絶大な効果をもたらします。そして現代の実務環境では、Pythonなどのツールを正しく制御し、特異性や数値安定性に目を配れる視点こそが真の武器となります。基本のアルゴリズムを確実に定着させ、難関とされる線形代数のハードルを自信を持って突破してください。 (出典: 逆 行列 求め 方(Yahoo!ニュース))
Webメディアの編集およびコンテンツ作成に従事。正確で質の高い情報発信を心掛けています。
