分散と標準偏差の違いとは?なぜ平方根にするのか疑問の真相を徹底解説
ビジネスの現場やデータ分析の講義で必ずと言っていいほど直面するのが、「分散」と「標準偏差」の壁です。平均値だけでは見えてこないリスクや偏りを暴くための必須ツールでありながら、「なぜわざわざ2乗するのか」「なぜ最後に平方根(ルート)をとるのか」「エクセルの関数がいくつもあってどれを使えばいいか分からない」と頭を抱える実務担当者は少なくありません。
平均点や売上の平均値だけを盲信すると、一部の極端な数値に惑わされ、事業判断やマーケティング施策で手痛い失敗を招きます。統計学の土台でありながら多くの人がつまずく分散と標準偏差の違いと使い分け、そして数式に隠された数学的な必然性を、実例と図解的な思考法を交えて解き明かしていきます。
📌 【この記事の重要ポイントまとめ】
- 要点1:分散は「数値の散らばりを2乗して平均したもの」であり、標準偏差はその分散に「平方根(√)をかけて元のデータの単位に戻したもの」。
- 要点2:平方根にする最大の理由は、2乗によって「円²」や「点²」に狂ってしまった単位を元の次元に戻し、平均値と直接比較できるようにするため。
- 要点3:エクセル実務では、目の前の全データそのものを対象にするなら「.P(標本分散・母集団)」、一部のサンプルから全体を推測するなら「.S(不偏分散・標本)」を選ぶのが鉄則。
【徹底図解】分散と標準偏差の違いと使い分け|平均値の罠を見破る基本
データ分析で最も身近な指標は「平均値」ですが、数学教育やデータサイエンスの現場で長年指摘されている通り、平均値だけではデータの実態を捉えることはできません。数学情報メディア『高校数学の美しい物語』でも整理されているように、データの特徴を把握するには「だいたいどれくらいの大きさか(代表値)」と「どれくらい散らばっているのか(散布度)」という2つの視点が不可欠です。
例えば、あるWebサービスにおけるAチームとBチームの成約件数を比較してみましょう。両チームともに5名のメンバーがおり、週間の平均成約数は「10件」で全く同じだとします。
- Aチームの成約数:9件、10件、10件、10件、11件(平均:10件)
- Bチームの成約数:1件、2件、10件、18件、19件(平均:10件)
平均値だけを見れば両者は同等のパフォーマンスに見えますが、実態は正反対です。Aチームは全員が安定して結果を出している組織であり、Bチームはトップセールス2名が全体の数字を牽引し、残るメンバーは深刻な不振に陥っています。この平均値とデータのばらつき評価を客観的な数値として浮き彫りにするのが「分散」と「標準偏差」の役割です。
両者の決定的な違いは「単位が揃っているかどうか」にあります。分散は計算の過程で数値を2乗するため、単位が「件数の2乗」になってしまい、直感的な比較ができません。一方、標準偏差は分散の平方根をとることで単位を元の「件」に戻しているため、「平均10件に対して、標準偏差は約7.5件のブレがある」というように、平均値と同じ土俵でばらつきの大きさを直感的に把握できるのです。

【疑問の真相】なぜ偏差を2乗し最後に平方根(ルート)をとるのか?
「データの散らばりを見たいなら、平均からのズレ(偏差)をそのまま合計して人数で割ればいいのではないか?」――これは統計学を学ぶ誰もが抱く自然な疑問です。しかし、そこには数学的な決定的なトラップが存在します。
平均値とは「すべてのデータの重心」であるため、各データの値から平均値を引いた値(偏差)をすべて足し合わせると、プラスとマイナスが完全に相殺されて合計が必ずゼロになってしまうのです。
これでは、どれほどデータが激しく散らばっていようが、散らばりが全く無かろうが、合計値は常にゼロになり、ばらつきの指標として機能しません。この問題を解消するために導入されたのが分散を2乗する数学的な理由と真相です。
マイナスの符号を消す方法としては「絶対値をつける(平均偏差)」というアプローチも存在します。しかし、絶対値を含む関数はグラフにした際に尖った角(V字型)が生まれ、微分ができないという致命的な数学的デメリットを抱えています。微小な変化や確率密度関数を扱う現代の統計学や機械学習アルゴリズムにおいて、微分可能で滑らかな関数を保つ「2乗」のアプローチが選ばれたのは、必然的な選択だったのです。
ところが、数値を2乗したことで新たな副作用が生まれます。それが「単位の次元が狂う」という問題です。テストの点数(点)を2乗すると「点²」になり、年収(万円)を2乗すると「万円²」になってしまいます。「平均年収500万円に対し、分散は400万平方万円です」と言われても、それが大きいのか小さいのか人間には直感的に理解できません。
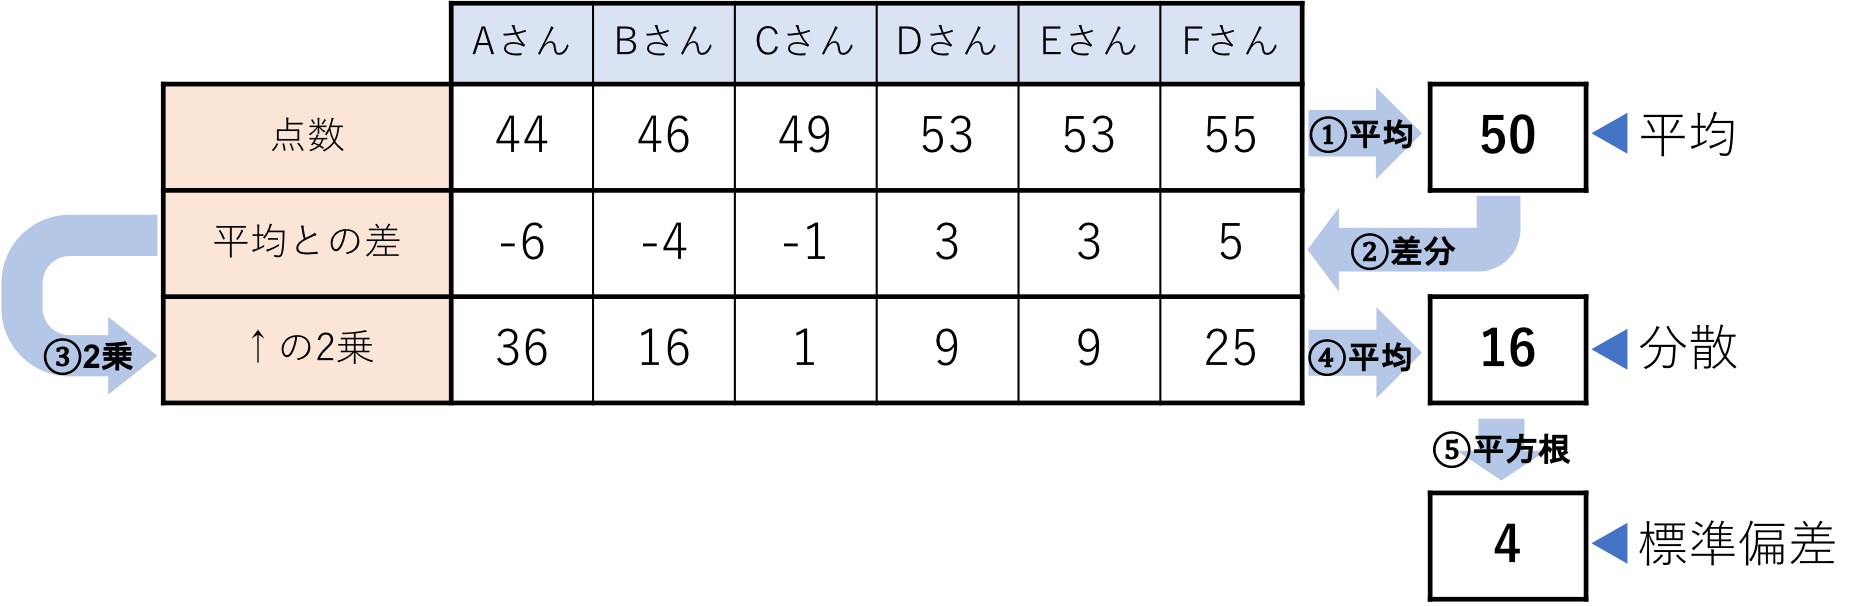
そこで登場するのが、標準偏差を平方根にする理由です。2乗して肥大化し、次元が変わってしまった数値をルート(√)で元に戻すことで、単位を「点」や「万円」に揃え、「平均500万円、標準偏差200万円」といった人間が直接理解できるものさしに復元しているのです。教育情報機関である進研ゼミ高校講座の指導データでも、計算の流れを「①平均 → ②偏差 → ③2乗 → ④2乗の平均(分散) → ⑤平方根(標準偏差)」という5段階のストーリーとして捉えることが、概念の完全な定着への最短ルートであると解説されています。
【公式と計算手順】分散の公式と計算方法まとめ|手計算と時短テクニック
数学やデータ処理の検定試験、あるいは実務のアルゴリズム構築において必要となる分散の公式と計算方法まとめを確認しておきましょう。分散の求め方には、基本に忠実な「定義式」と、計算スピードを劇的に上げる「展開公式」の2通りが存在します。
数学教育サイト『「意味から分かる」数学準備室』でも推奨されている通り、基本の定義式は「偏差の2乗の平均」です。
分散(定義式):
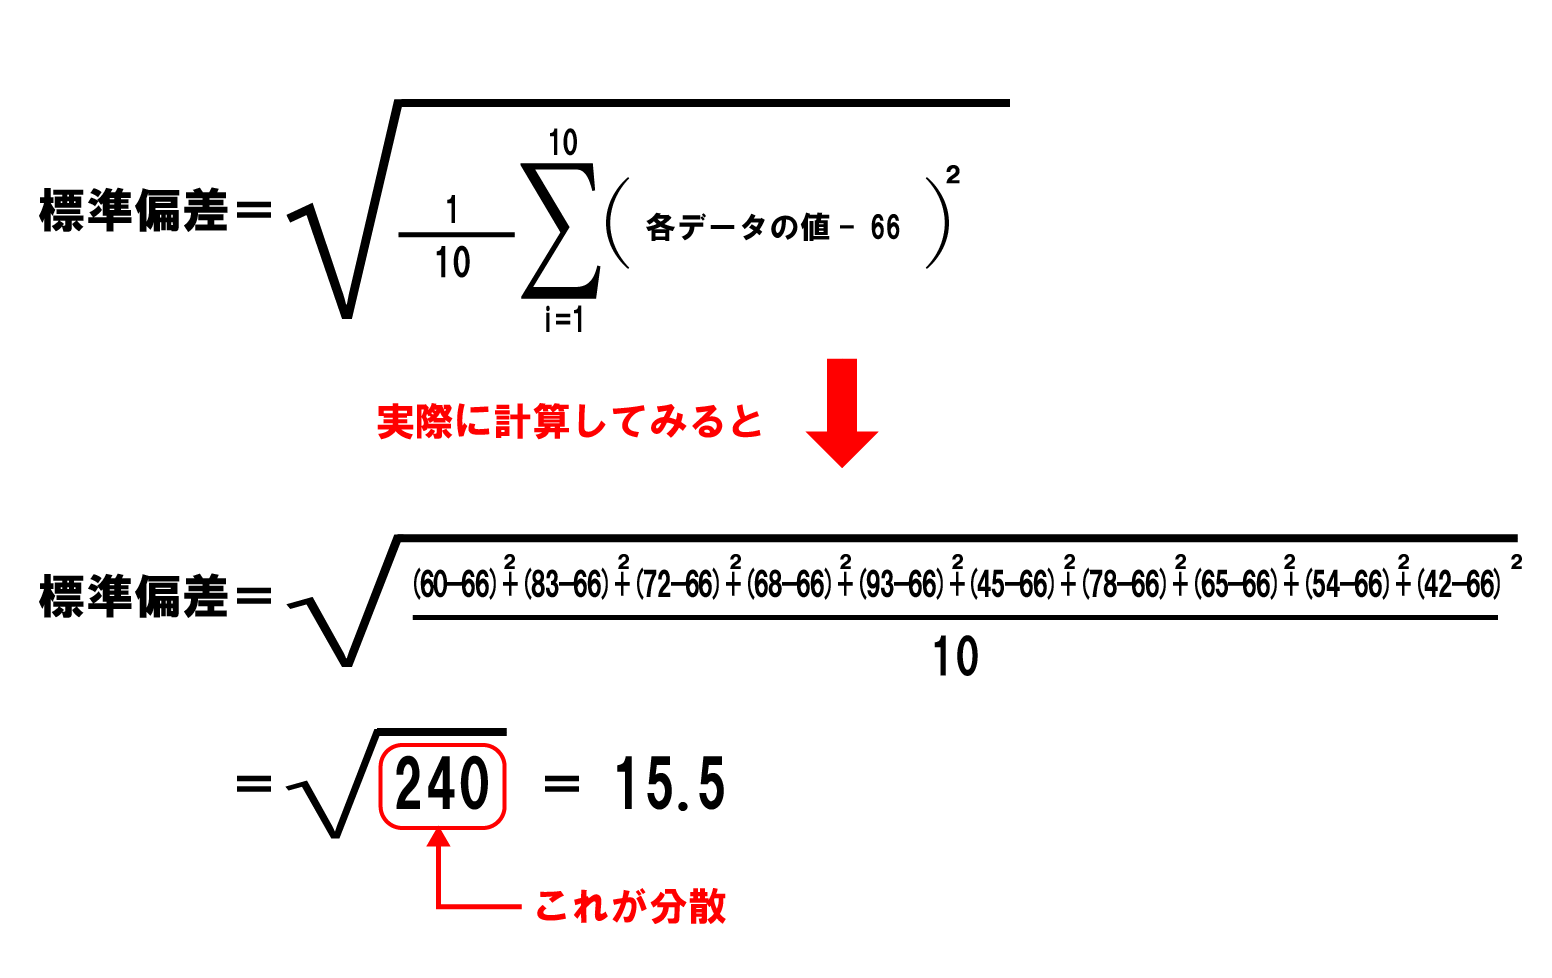
$s^2 = \frac{1}{n} \sum_{i=1}^{n} (x_i - \bar{x})^2$
この式は概念を理解しやすい反面、平均値($\bar{x}$)が割り切れない小数になった場合、各データから小数を引いて2乗する計算を繰り返すことになり、手計算では膨大な時間と計算ミスを誘発します。そこで実務や試験で重宝されるのが、数式を展開して得られる以下のバイパス公式です。
分散(展開公式・時短テクニック):
「分散 = (各データの2乗の平均) − (平均値の2乗)」
この公式を用いれば、まず個々のデータをそのまま2乗してその平均を出し、後から平均値全体の2乗を引くだけで分散が一発で求まります。データ分析プログラミングやSQLで集計処理を行う際も、この公式のロジックが背後で活用されることで計算負荷の大幅な削減が実現されています。
【比較表で一目瞭然】不偏分散と標本分散の決定的な違い|nかn−1か
統計学を実務に適用する際、初学者が最も混乱するのが「データを割る数は $n$(データ数)なのか、$n-1$ なのか」という問題です。科学技術系メディア『kei-science』が指摘するように、この使い分けの根底には不偏分散と標本分散の決定的な違いが横たわっています。
手元にあるデータそのものが分析のゴールである「母集団全体(全数データ)」であれば、単純にデータ数 $n$ で割る「標本分散(母分散)」を用います。しかし、現実のビジネス分析の多くは、限られたサンプル(標本)から日本全体や顧客全体の真のばらつきを「推測」する作業です。
標本から計算した平均値は、どうしてもそのサンプルデータ特有の偏りを反映してしまいます。その偏った標本平均を使って分散を計算すると、真のばらつき(母分散)よりも数値がわずかに小さく見積もられてしまう(過小評価される)という数学的性質があるのです。その縮こまった誤差を補正し、より正確な推測値を得るために、分母をあえて1つ減らした「$n-1$」で割る手法が「不偏分散」です。
| 指標・分類 | 割る数と計算の狙い | エクセル(Excel)関数 | 編集部の実務推奨・使い分け基準 |
|---|---|---|---|
| 標本分散 / 母分散 | $n$(全データ数)で割る 目の前のデータ全体の散らばりをそのまま算出 | VAR.P | 学校の全校生徒テスト、自社保有の全顧客データなど、母集団そのものが完結している場合に採用。 |
| 不偏分散 | $n-1$(自由度)で割る サンプルの過小評価を防ぎ母集団を正しく推測 | VAR.S | 抜き取り検査、一部アンケート調査、マーケティングの抽出サンプルなど、全体を推測する実務全般。 |
| 母標準偏差 | 標本分散の平方根 単位を元の数値に戻した確定値 | STDEV.P | 全社員の勤怠時間や売上実績など、推測ではなく実績値の確定評価を行うレポート作成時に必須。 |
| 標本標準偏差 | 不偏分散の平方根 母集団の標準偏差を精度高く推計 | STDEV.S | 現代の実務で最も頻繁に使用される基本関数。一般的な統計的仮説検定の前提として機能。 |
オフィス業務におけるエクセルでの分散と標準偏差の求め方では、過去のバージョンの関数との互換性に留意が必要です。従来のExcelでは「STDEV」という関数が広く使われていましたが、これは標本を対象とした「$n-1$ で割る」計算式でした。しかし、全数調査と標本調査の混同による実務上の算出ミスが多発したことを受け、Microsoftは明確に末尾で識別できる関数群(Populationの「.P」とSampleの「.S」)へ移行させました。これがSTDEV.PとSTDEV.Sの使い分け経緯です。現在の実務現場では、誤用を防ぐためにも「.S」か「.P」を明示的に入力することがガバナンス上の標準作法となっています。
【直感理解】正規分布における標準偏差の目安と「偏差値」のカラクリ
標準偏差の数値を算出した後、それをどう実務の評価に落とし込むのか。その鍵を握るのが、統計学の基本モデルである「正規分布」です。データが左右対称の釣り鐘型の分布を描くとき、平均値($\mu$)と標準偏差($\sigma$)の間には極めて厳密な確率のルールが存在します。これが正規分布における標準偏差の目安です。
- 平均値 ± 1σ の範囲:全体の約68.3%のデータが収まる
- 平均値 ± 2σ の範囲:全体の約95.4%のデータが収まる
- 平均値 ± 3σ の範囲:全体の約99.7%のデータが収まる(ほぼ100%)
教育現場や人事評価で活用される例として、『kei-science』が示す「テストの平均点が70点・標準偏差が10点」のケースを考えてみましょう。この場合、「平均 ± 1σ」は「60点〜80点」となり、受験生の約68%がこのゾーンにひしめき合っていることが分かります。そして「平均 ± 2σ」である「50点〜90点」の範囲には、全生徒の約95%が含まれます。つまり、90点を超える生徒は上位わずか約2.5%の超優秀層であると客観的に断定できるのです。
日本人に極めて馴染み深い「偏差値」も、この標準偏差の性質を巧みに利用したシステムです。異なる難易度の試験結果を同じ基準で比較できるよう、「平均値を偏差値50、標準偏差を10」に強制変換する計算式が組まれています。
偏差値の換算式:
偏差値 = 50 + 10 × (個人の得点 − 平均点) ÷ 標準偏差
これが偏差値と標準偏差の違いの真相です。標準偏差はあくまで「その集団の点数がどれだけ散らばっているかを表す絶対値」であり、偏差値は「標準偏差を使って、自分が集団全体のどの位置(上位何%)にいるかを規格化した相対値」なのです。標準偏差が大きければ(ばらつきが激しければ)平均から離れていても偏差値の変動は緩やかになり、標準偏差が小さければ(全員が僅差なら)わずか数点の差で偏差値が劇的に跳ね上がります。
【実務検証】2026年最新データ分析での活用事例と現場が陥る3大トラップ
ビッグデータとAIが業務の隅々まで浸透した現在、2026年最新データ分析での活用事例においても分散と標準偏差の重要性は色褪せるどころか、むしろ高度な意思決定の防波堤として存在感を増しています。データ分析情報メディア『スタビジ』がPythonを用いた機械学習の前処理や特徴量エンジニアリングを詳解しているように、現代のAIアルゴリズムの精度はデータのばらつきをいかに適切にスケーリング(標準化)できるかに直結しているからです。
しかし、高度なBIツールや自動分析が普及した今だからこそ、現場のビジネスパーソンが陥りがちな3つの罠が顕在化しています。
1. 極端な外れ値による「標準偏差の歪み」トラップ
標準偏差はすべてのデータを2乗して計算するため、極端な外れ値(異常値)の影響を極めて強く受けるという弱点があります。例えば、従業員10名の零細企業に1人だけ年収1億円の役員が混ざると、分散と標準偏差は天文学的な数値に跳ね上がり、一般社員のリアルなばらつきを全く反映しなくなります。SNSや業務現場の検証データでも、「標準偏差だけを見て施策を打ったら、たった1件のバグデータに振り回されていた」というトラブル報告が後を絶ちません。外れ値が存在する環境では、四分位範囲(IQR)や中央値との併用が不可欠です。
2. 異なる単位を無理に比較する「変動係数(CV)の欠如」トラップ
「A商品の売上(平均1,000円、標準偏差200円)」と「B商品の売上(平均10万円、標準偏差1万円)」を比較して、「B商品の方が標準偏差が大きいためリスクが高い」と判断するのは初歩的な誤りです。平均規模が全く異なるデータを比較する際は、標準偏差を平均値で割った変動係数(CV: Coefficient of Variation)を用いなければなりません。A商品のCVは「200 ÷ 1,000 = 0.20」、B商品のCVは「10,000 ÷ 100,000 = 0.10」となり、相対的なリスクはむしろA商品の方が2倍高いという真実が浮かび上がります。
3. 非正規分布(べき乗則)への「正規分布の目安」当てはめトラップ
Webサイトのアクセス数、アプリ課金額、SNSのリツイート数などは、正規分布ではなく「ロングテール(べき乗則)」の分布をとります。これらは一握りの要素が全体の数値を支配する歪んだ構造をしているため、「平均値 ± 2σ に95%が収まる」という正規分布の経験則は一切通用しません。データのヒストグラム(形状)を確認しないまま機械的に標準偏差のルールを適用することは、重大な経営判断ミスを招きます。
【プロの結論】データ分析を意思決定に昇華させるための判断基準
実務家が分散・標準偏差を扱う際の最適解は、「データの目的」と「母集団の定義」を明確に切り分けることに尽きます。以下の判断基準をチェックシートとして実務に導入してください。
- 標準偏差(STDEV.S)を使うべきケース:
- 新商品サンプルのABテストやマーケティングアンケートから、市場全体の動向を推計したい場合。
- 製造業の抜き取り検査ラインにおいて、ロット全体の不良品発生リスクを許容範囲内に管理したい場合。
- 標準偏差(STDEV.P)を使うべきケース:
- 確定した社内評価データ(全従業員の人事考課や全店舗の年間売上)の安定性を内部監査・報告する場合。
- 標準偏差の使用を避け、四分位範囲や中央値に切り替えるべきケース:
- 資産額、役員報酬、Webトラフィックなど、超富裕層や爆発的バズといった外れ値が日常的に発生する領域。
【分散と標準偏差】に関するよくある質問(FAQ)
Q1:分散と標準偏差のどちらを上司やクライアントへの報告書に記載すべきですか?
A1:原則として「標準偏差」を記載してください。分散は計算過程で2乗されているため単位が異なり、直感的なビジネス判断には使えません。「売上平均100万円に対し、ブレ幅を表す標準偏差は15万円」と提示することで、関係者全員がブレのリスクを正しく共有できます。分散はあくまで標準偏差を算出するための数学的な中継地点と考えるのが実務的です。
Q2:エクセルで標準偏差を計算するとき、STDEV.PとSTDEV.Sのどちらを選べばいいか迷ったら?
A2:迷った場合は「STDEV.S」を選択するのが実務上の安全策です。ビジネスで扱うデータのほとんどは、母集団全体ではなく「過去一定期間のログ」や「一部の顧客データ」といったサンプル(標本)に過ぎないためです。また、データ件数が数百〜数千件を超えると「$n$ で割る」か「$n-1$ で割る」かの数値差は実質的に無視できるほど微小になりますが、統計学的な厳密性を担保する上でも「.S」が標準となっています。
Q3:標準偏差が「ゼロ」になるのはどんな時ですか?またマイナスになることはありますか?
A3:すべてのデータが全く同じ値である場合のみ、標準偏差は「ゼロ」になります。例えばテストの受験者全員が80点だった場合、ばらつきが一切存在しないため標準偏差はゼロです。また、偏差を2乗した正の実数の平方根をとるため、標準偏差がマイナス(負の数)になることは数学的に絶対にありません。もし計算結果がマイナスになった場合は、計算手順や数式の参照範囲に誤りがあります。
まとめ:データのばらつきを制する者が分析を制する
分散と標準偏差の仕組みを紐解くと、そこには「プラスとマイナスの相殺を防ぐための2乗」と、「狂った単位を現実のスケールに引き戻すための平方根」という、明快かつ美しい数学的合理性が貫かれています。両者の本質を捉えることは、難解な数式を暗記することではなく、平均値という単一の数字に隠された「リアルな振れ幅とリスク」を正しく見抜く目を養うことに他なりません。
エクセル関数の使い分けに迷ったときは、手元のデータが「全体そのもの(.P)」なのか「全体を推し量るサンプル(.S)」なのかという原点に立ち返ってください。分散と標準偏差という強力なコンパスを正しく使いこなすことで、不確実な数値の海から本質的な洞察を導き出し、精度の高い意思決定を実現していきましょう。 (出典: 分散 と 標準 偏差(Yahoo!ニュース))
情報を整理して届けることが得意なWebディレクター。ユーザー視点に立った記事作成を目指しています。
